ChatGPT-യോടോ Gemini-യോടോ ഒരു ചോദ്യം ചോദിച്ചാൽ നിമിഷനേരം കൊണ്ട് ഉത്തരം കിട്ടുന്നത് കണ്ടിട്ട് ഇത് വളരെ ലളിതമായ ഒരു കാര്യമാണെന്ന് തോന്നാം. "എന്താണ് കാലാവസ്ഥ?" എന്ന് ചോദിച്ചാൽ ഉടനെ മറുപടി വരുന്നു. പക്ഷേ ഇതിന് പിന്നിൽ അതിഭീമമായ ഒരു സാങ്കേതിക പ്രക്രിയ തന്നെ നടക്കുന്നുണ്ട് - സാധാരണ കമ്പ്യൂട്ടർ പ്രോസസ്സറുകൾക്ക് (CPU) കൈകാര്യം ചെയ്യാൻ പറ്റാത്തത്ര വലിയ കണക്കുകൂട്ടലുകൾ ആണ് ഇതിന് വേണ്ടിവരുന്നത്. അതുകൊണ്ടാണ് GPU, TPU പോലുള്ള അതിശക്തമായ ചിപ്പുകൾ ഇതിന് ആവശ്യമായി വരുന്നത്.
AI ശരിക്കും എന്താണ് ചെയ്യുന്നത്?
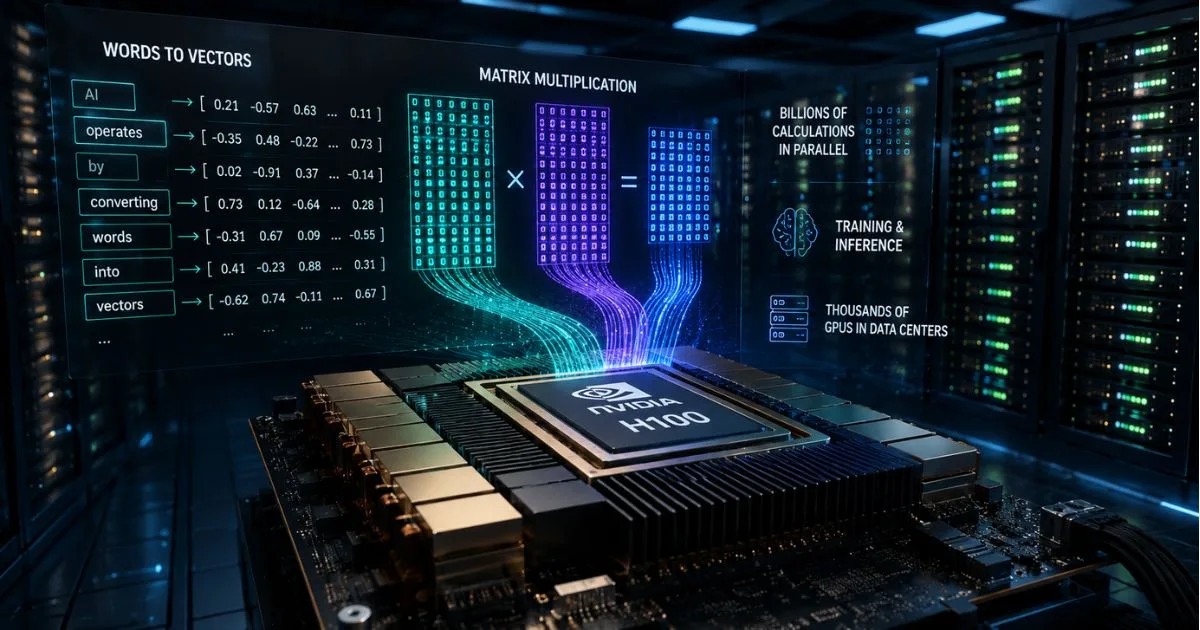
നമ്മളെപ്പോലെ ചിന്തിക്കുകയോ മനസ്സിലാക്കുകയോ അല്ല എഐ ചെയ്യുന്നത് - അതൊരു വലിയ മാത്തമാറ്റിക്കൽ മോഡൽ ആണ്. നമ്മൾ നൽകുന്ന ഓരോ വാക്കിനെയും എഐ ആദ്യം 'വെക്റ്ററുകൾ' (Vectors) എന്ന് വിളിക്കുന്ന കോടിക്കണക്കിന് അക്കങ്ങളുടെ കോമ്പിനേഷനായി മാറ്റും. അടുത്തതായി ഏത് വാക്കാണ് വരേണ്ടതെന്ന് തീരുമാനിക്കാൻ ഇത് കോടിക്കണക്കിന് സമവാക്യങ്ങൾ (Matrix Multiplications) ഒരേസമയം പരിഹരിക്കും. നമ്മൾ ഒരു ചോദ്യം ചോദിക്കുമ്പോൾ, ചോദ്യത്തിലെ അവസാന വാക്കിന് ശേഷം ഏറ്റവും സാധ്യതയുള്ള അടുത്ത വാക്ക് ഏതാണെന്ന് കണ്ടെത്താൻ എഐ ഇത്തരം കോടിക്കണക്കിന് കാൽക്കുലേഷനുകൾ സെക്കൻഡുകൾക്കുള്ളിൽ ചെയ്തുതീർക്കുന്നു.
"AI വാക്കുകളെ അക്കങ്ങളായി മാറ്റി, അവ തമ്മിലുള്ള ബന്ധം ഗണിതശാസ്ത്രപരമായി കണക്കാക്കിയാണ് മറുപടി നൽകുന്നത്. ഇതൊരു 'പ്രെഡിക്ഷൻ' പ്രക്രിയയാണ്, ചിന്തയല്ല."
എന്തുകൊണ്ട് സാധാരണ CPU പോരാ?
ഇവിടെയാണ് ശക്തിയേറിയ ചിപ്പുകളുടെ ആവശ്യം വരുന്നത്. നമ്മുടെ കമ്പ്യൂട്ടറിലുള്ള സാധാരണ CPU വളരെ വേഗത്തിൽ പ്രവർത്തിക്കുമെങ്കിലും, അതിന് ഒരേസമയം ഒന്നോ രണ്ടോ സങ്കീർണ്ണമായ ജോലികൾ മാത്രമേ ചെയ്യാൻ കഴിയൂ. എന്നാൽ എഐ മോഡലുകൾക്ക് വേണ്ടത് ഒരേസമയം ദശലക്ഷക്കണക്കിന് ചെറിയ കണക്കുകൂട്ടലുകൾ ഒരുമിച്ച് ചെയ്യാനുള്ള ശേഷിയാണ് - ഇതിനെ Parallel Processing എന്ന് പറയാം. എൻവിഡിയ നിർമ്മിക്കുന്ന ജിപിയു ചിപ്പുകളിൽ അയ്യായിരത്തിലധികം കുഞ്ഞു പ്രോസസ്സിംഗ് കോറുകൾ ഉണ്ടാകും, ഇവയ്ക്ക് ഒരേ നിമിഷത്തിൽ ദശലക്ഷക്കണക്കിന് അക്കങ്ങൾ കൂട്ടാനും ഗുണിക്കാനും കഴിയും. ChatGPT പോലുള്ള ഒരു മോഡൽ പ്രവർത്തിപ്പിക്കാൻ Nvidia H100, B200 പോലുള്ള പതിനായിരക്കണക്കിന് ഹൈ-എൻഡ് ജിപിയു ചിപ്പുകൾ ഒരുമിച്ച് അണിനിരത്തിയ വലിയ ഡാറ്റാ സെന്ററുകൾ തന്നെ ആവശ്യമായി വരും.
ട്രെയിനിംഗും ഇൻഫറൻസും: രണ്ട് വലിയ ഘട്ടങ്ങൾ
ChatGPT പോലുള്ള വലിയ ലാംഗ്വേജ് മോഡലുകൾ പ്രധാനമായും രണ്ട് ഘട്ടങ്ങളിലൂടെയാണ് കടന്നുപോകുന്നത്:
- ട്രെയിനിംഗ് ഘട്ടം (Training Phase): ഇന്റർനെറ്റിലുള്ള കോടിക്കണക്കിന് പുസ്തകങ്ങളും വെബ്സൈറ്റുകളും ലേഖനങ്ങളും വായിച്ചു പഠിക്കുന്ന ഘട്ടം. ഈ വിവരങ്ങളിൽ നിന്ന് വാക്കുകൾ തമ്മിലുള്ള ബന്ധം മനസ്സിലാക്കാൻ എഐ അതിന്റെ പരാമീറ്ററുകൾ ക്രമീകരിക്കും - ചില വലിയ മോഡലുകളിൽ ഒരു ട്രില്യണിലധികം പരാമീറ്ററുകൾ വരെ ഉണ്ടാകാം. ഇത് മാസങ്ങളോളം നീണ്ടുനിൽക്കുന്ന ഒരു പ്രക്രിയയാണ്, ദശലക്ഷക്കണക്കിന് ഡോളർ വിലമതിക്കുന്ന ചിപ്പുകളും വൻതോതിലുള്ള വൈദ്യുതിയും ഇതിന് ആവശ്യമായി വരും.
- ഇൻഫറൻസ് ഘട്ടം (Inference Phase): നമ്മൾ ചോദ്യം ചോദിച്ചാൽ മറുപടി കിട്ടുന്ന ഘട്ടം. ട്രെയിനിംഗിനോളം പവർ ഇതിന് വേണ്ടെങ്കിലും, ലോകമെമ്പാടുമുള്ള ദശലക്ഷക്കണക്കിന് ആളുകൾ ഒരേസമയം ചോദ്യങ്ങൾ ചോദിക്കുമ്പോൾ എല്ലാവർക്കും വേഗത്തിൽ മറുപടി കൊടുക്കാൻ ശക്തമായ സർവറുകളും ജിപിയു ചിപ്പുകളും തന്നെ ആവശ്യമായി വരും.
ഉപസംഹാരം
ചുരുക്കി പറഞ്ഞാൽ, നമ്മൾ എഐയോട് ചോദിക്കുന്ന ഏറ്റവും ലളിതമായ ചോദ്യത്തിന് പിന്നിൽ പോലും കോടിക്കണക്കിന് അക്കങ്ങളുടെ മൾട്ടിപ്ലിക്കേഷൻ വളരെ വേഗത്തിൽ നടക്കുന്നുണ്ട്. ഈ ഭീമമായ ഗണിതക്രിയകൾ ഒരു സെക്കൻഡിന്റെ ചെറിയൊരംശം കൊണ്ട് ചെയ്തുതീർക്കാൻ വേണ്ടിയാണ് എഐ കമ്പനികൾ വൻതുക മുടക്കി ഇത്രയും പവർഫുൾ ചിപ്പുകൾ ഉപയോഗിക്കുന്നത്. അടുത്ത തവണ AI യോട് ചോദിക്കുമ്പോൾ, അതിന് പിന്നിൽ പ്രവർത്തിക്കുന്ന ആയിരക്കണക്കിന് GPU കോറുകളെ ഓർക്കുക.
Story Summary:- AI operates by converting words into vectors and performing billions of matrix multiplications simultaneously, a task requiring the parallel processing power of specialized GPU/TPU chips rather than standard CPUs. This immense computational load explains why data centers rely on thousands of high-end chips like Nvidia H100s to handle both training and real-time inference efficiently.
Keywords: AI Working Principle, GPU Parallel Processing, Matrix Multiplication in AI